Gestión de memoria y planificación del disco#
Jerarquía de memoria#
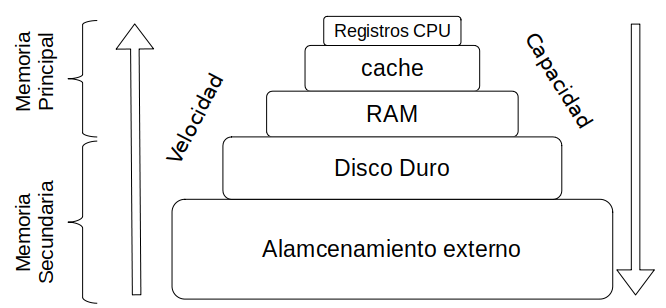
La jerarquía de memoria es la organización piramidal de la memoria en niveles, el objetivo es acercar el rendimiento de una memoria de gran velocidad al coste de una memoria de baja velocidad.
La memoria principal#
La memoria principal es la memoria RAM; entre la CPU y ella se sitúa la memoria caché, un nivel más rápido y pequeño de la jerarquía.
Para tener varios procesos a la vez en memoria (multiprogramación), la memoria principal se divide en particiones. En un principio se adoptaron dos formas de hacerlo: particiones fijas o dinámicas.
Las particiones fijas se creaban al arrancar el ordenador. Si queríamos correr un proceso más grande que el tamaño de las particiones, teníamos que reiniciar el ordenador. Además, como se ve en la siguiente figura, las particiones fijas favorecen la fragmentación interna: el espacio que queda sin usar dentro de una partición cuando el proceso es más pequeño que ella.
Imaginemos una memoria de 64 KB con 4 particiones de 16 KB = 24·210 = 214 bytes = 0x4000.
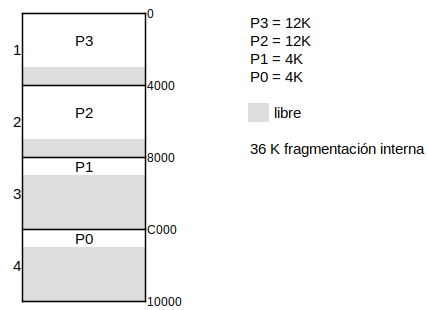
Con las particiones dinámicas se consiguió evitar la fragmentación interna, sin embargo aparece la fragmentación externa: huecos libres entre procesos que, por separado, son demasiado pequeños para alojar uno nuevo. Esto hace necesaria la compactación de la memoria.

Memoria virtual#
En 1961, Fotheringham describió una nueva técnica de gestión llamada memoria virtual, desarrollada para el ordenador Atlas. La idea es que el proceso que queremos correr puede ser mayor que la memoria disponible para ese proceso: el SO guarda en la memoria principal las partes del programa de uso corriente y el resto lo deja en el disco.
Es lógico pensar que no todas las partes del programa van a ser utilizadas al mismo tiempo. Los programas cumplen el principio de localidad:
Localidad temporal: si se usa una dirección, es probable que se vuelva a usar pronto (por ejemplo, las instrucciones de un bucle).
Localidad espacial: si se usa una dirección, es probable que se usen pronto las cercanas (por ejemplo, la instrucción siguiente o el siguiente elemento de un array).
Paginación#
La forma más habitual de implementar la memoria virtual es la paginación:
El espacio de direcciones de cada proceso (direcciones lógicas o virtuales) se divide en bloques del mismo tamaño llamados páginas.
La memoria principal (direcciones físicas) se divide en bloques de ese mismo tamaño llamados marcos.
Cada página puede estar cargada en cualquier marco libre o guardada en el disco.
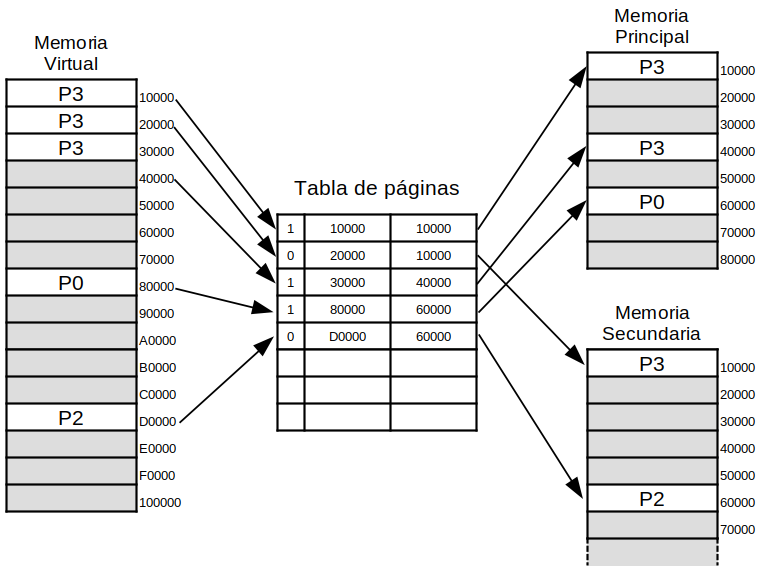
La transformación del número de página virtual al número de marco físico se realiza mediante la tabla de páginas, que tiene cada proceso. Cada entrada indica, entre otras cosas, si la página está en memoria principal (bit de presencia), en qué marco está y si se ha modificado desde que se cargó (bit de modificado). Esta traducción la hace por hardware la MMU (Memory Management Unit) en cada acceso a memoria; para no tener que consultar la tabla cada vez, guarda las traducciones más recientes en una pequeña caché llamada TLB (Translation Lookaside Buffer).
Uno de los sistemas más comunes de memoria virtual es la denominada paginación por demanda. Los procesos se inician sin ninguna página en memoria; cuando se intenta ejecutar la primera instrucción se produce un fallo de página (por no encontrarse la página en memoria principal), que provoca que el sistema operativo traiga la página del disco a la memoria principal. Después de un cierto tiempo, gracias a la localidad, el proceso tiene la mayoría de las páginas que necesita y la ejecución se realiza con un número relativamente pequeño de fallos de página.
Reemplazo de páginas#
Cuando se produce un fallo de página, la página se carga desde el disco en un marco libre. Si no queda ningún marco libre, hay que elegir una página víctima y sacarla de memoria; si esa página se ha modificado (bit de modificado a 1), antes hay que escribirla en el disco. La víctima la elige el algoritmo de reemplazo:
FIFO (First In, First Out): sale la página que lleva más tiempo en memoria.
LRU (Least Recently Used): sale la página que hace más tiempo que no se usa.
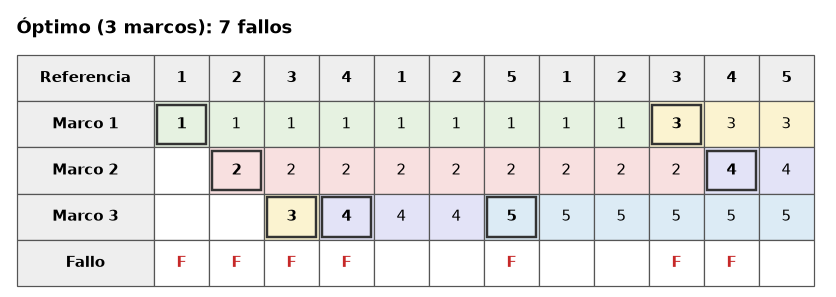
Óptimo: sale la página que más tarde se va a volver a usar. Da el menor número de fallos posible, pero no se puede implementar porque exige conocer el futuro; sirve como referencia para comparar los demás. Si hay empate (por ejemplo, varias páginas que no se vuelven a usar), sale la que lleva más tiempo en memoria.
Para orientarnos, en las siguientes pestañas están, paso a paso, las 12 referencias del ejemplo de abajo con FIFO: un proceso con 5 páginas y una memoria principal con solo 3 marcos, inicialmente libres. En la tabla de páginas, las páginas con bit de presencia 1 indican en qué marco están; las que tienen 0 están en el disco. El recuadro grueso marca la página que entra (y la que sale al disco) y en amarillo están las filas de la tabla que cambian.
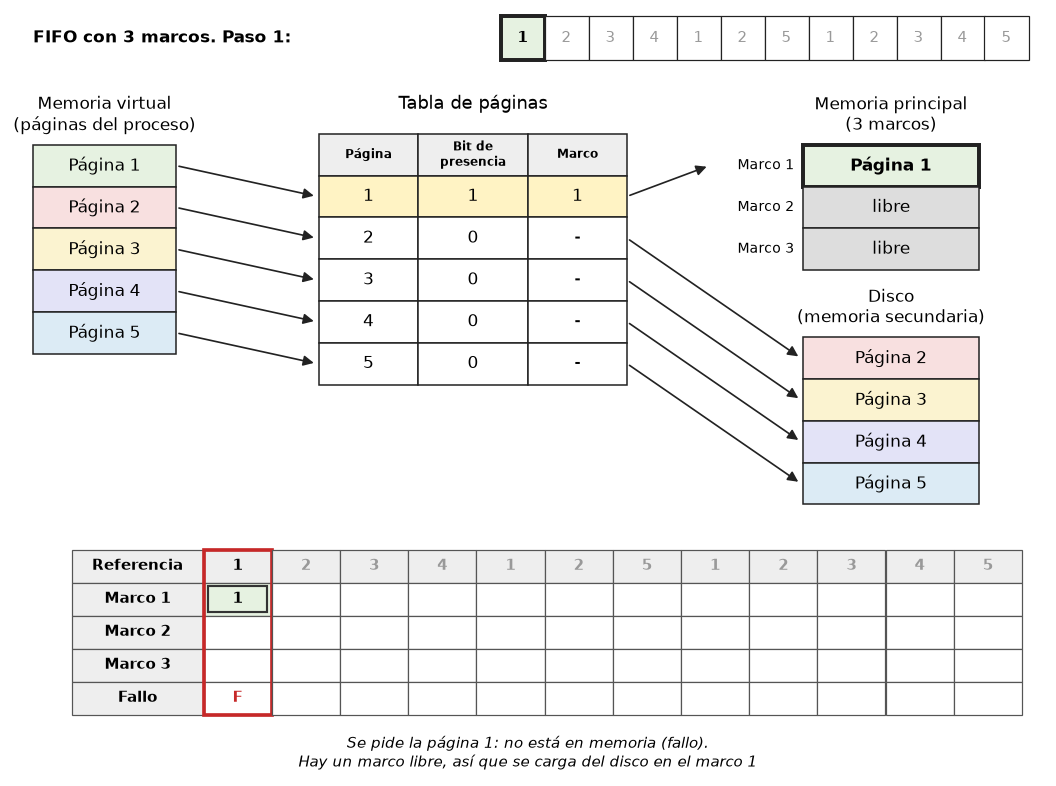
Paso 1: se pide la página 1; hay marcos libres y entra en el marco 1.
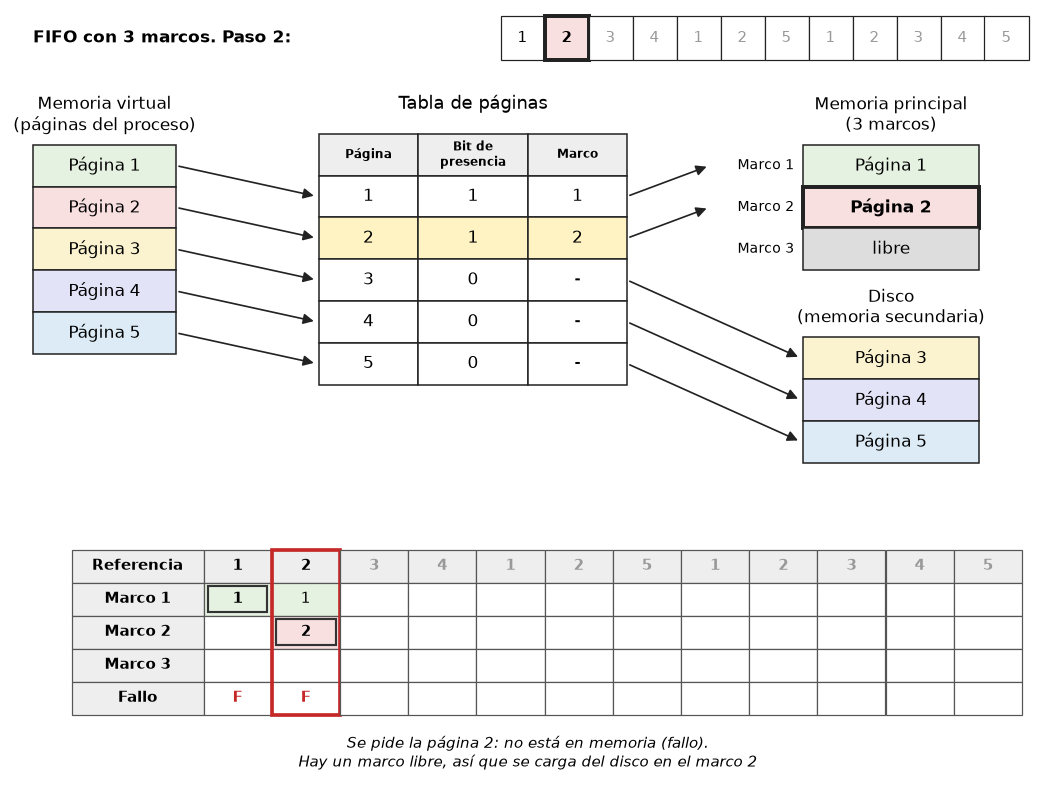
Paso 2: se pide la página 2 y entra en el marco 2.
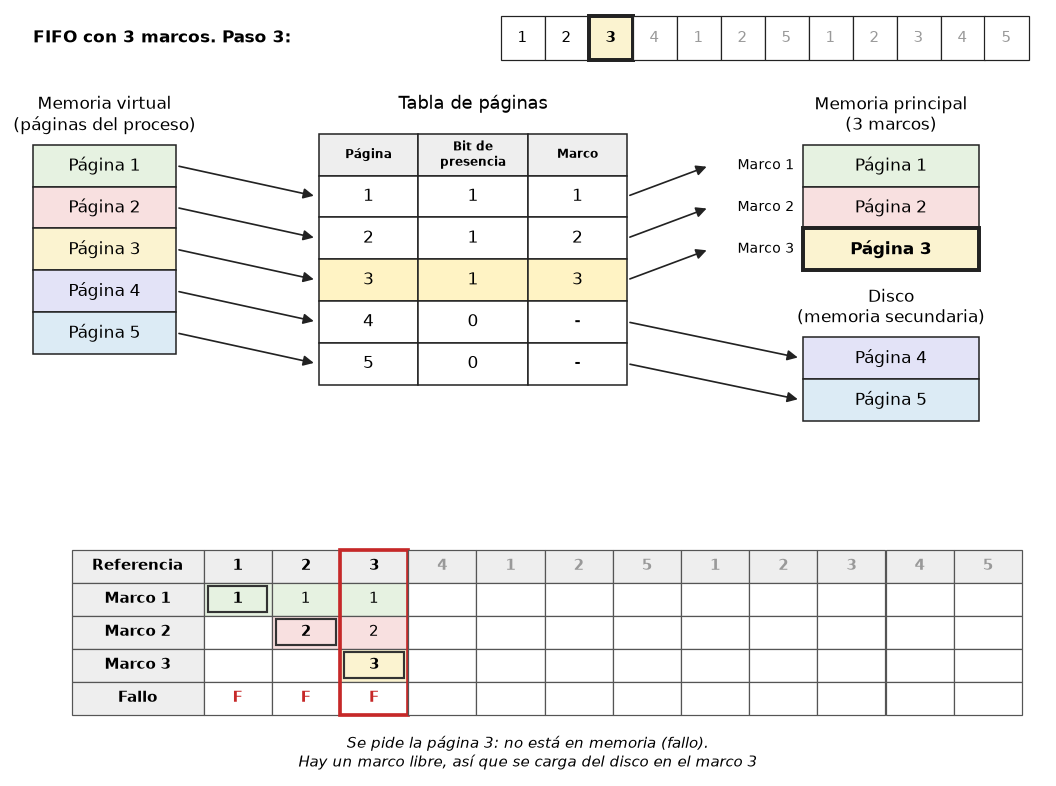
Paso 3: se pide la página 3 y entra en el marco 3; ya no quedan marcos libres.
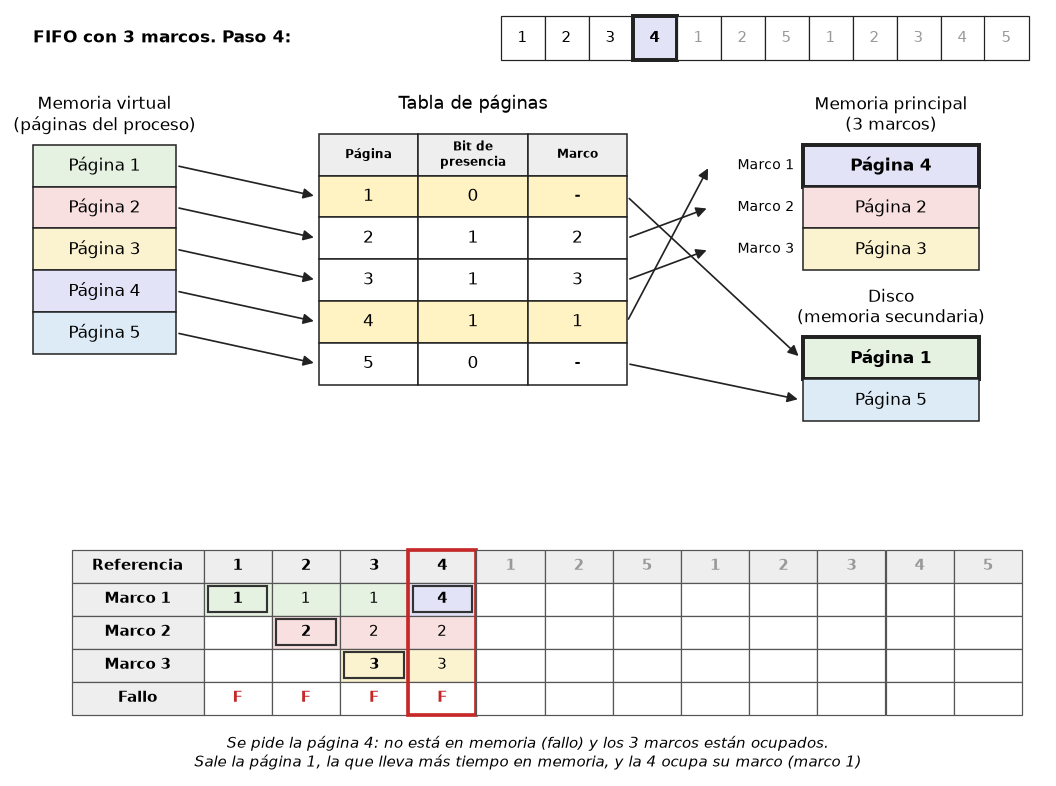
Paso 4: se pide la página 4 y no hay sitio: sale la página 1, la que lleva más tiempo en memoria, y la 4 ocupa el marco 1. Es el primer reemplazo.
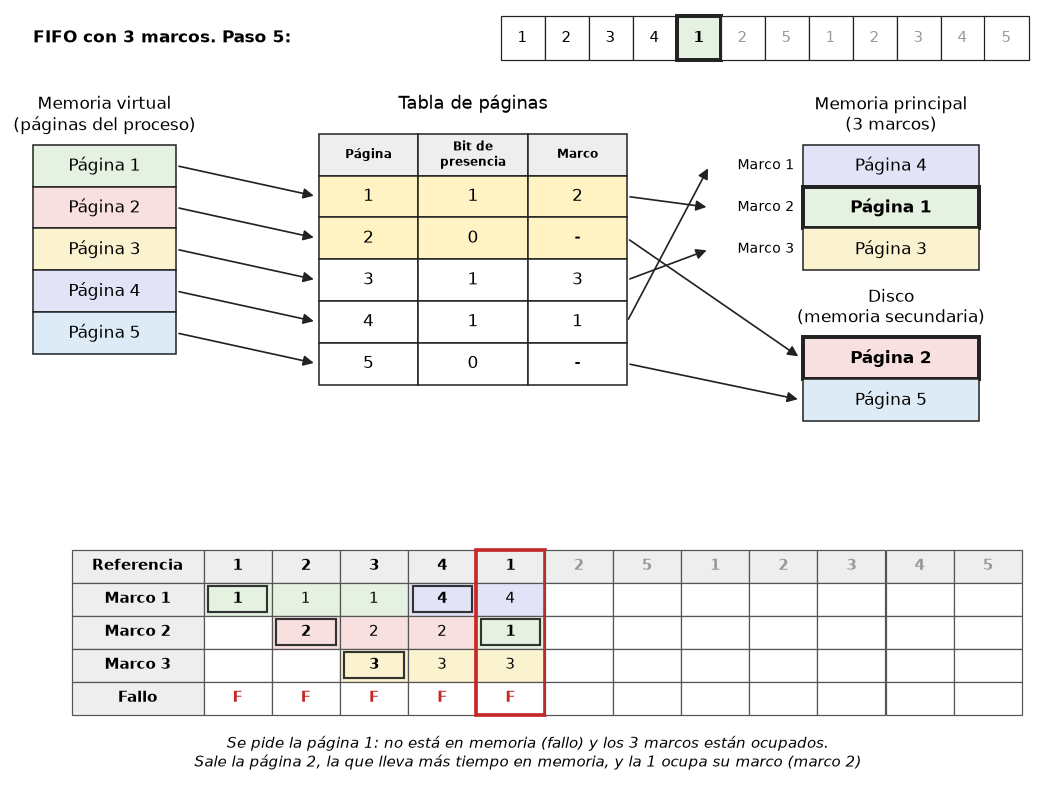
Paso 5: se pide la página 1, que acaba de salir: fallo. Sale la página 2, la que lleva más tiempo en memoria, y la 1 ocupa el marco 2.
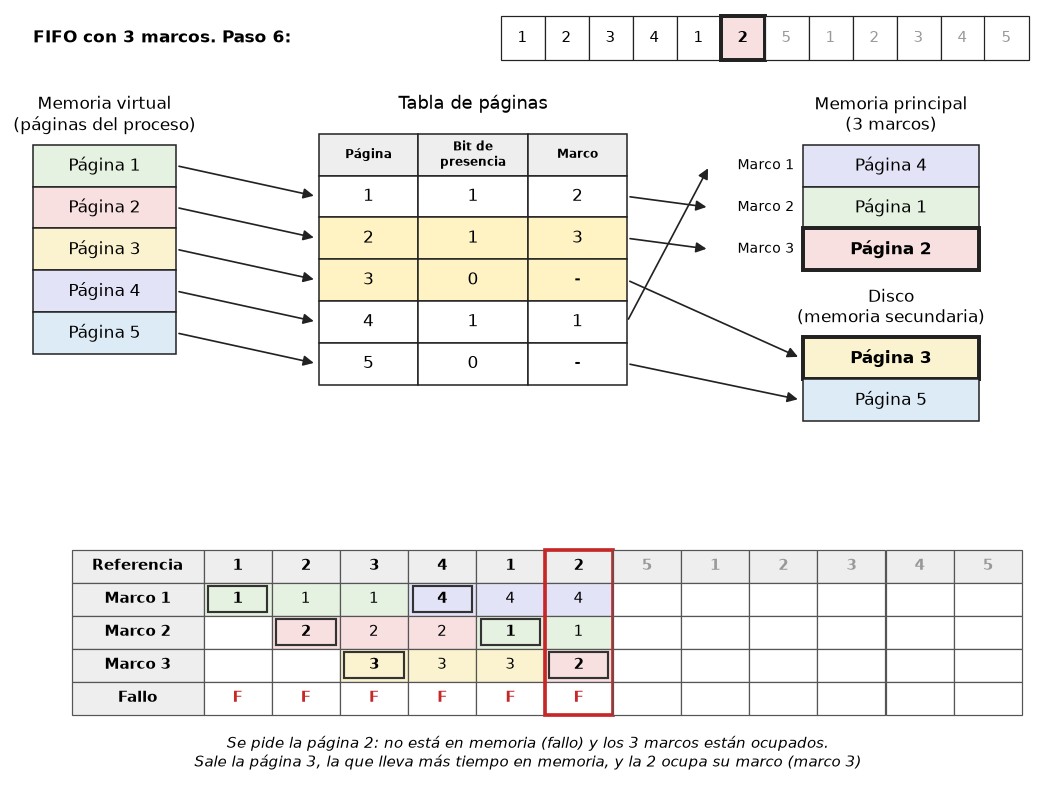
Paso 6: se pide la página 2: fallo. Sale la página 3 y la 2 ocupa el marco 3.
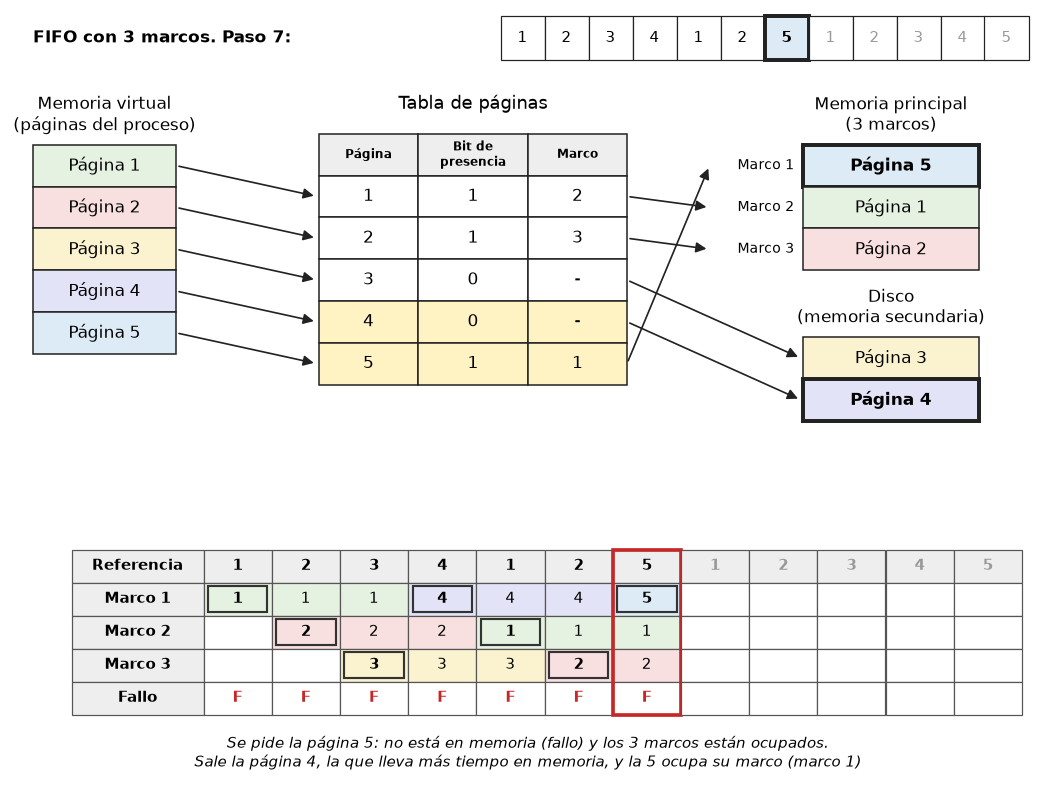
Paso 7: se pide la página 5: fallo. Sale la página 4 y la 5 ocupa el marco 1.
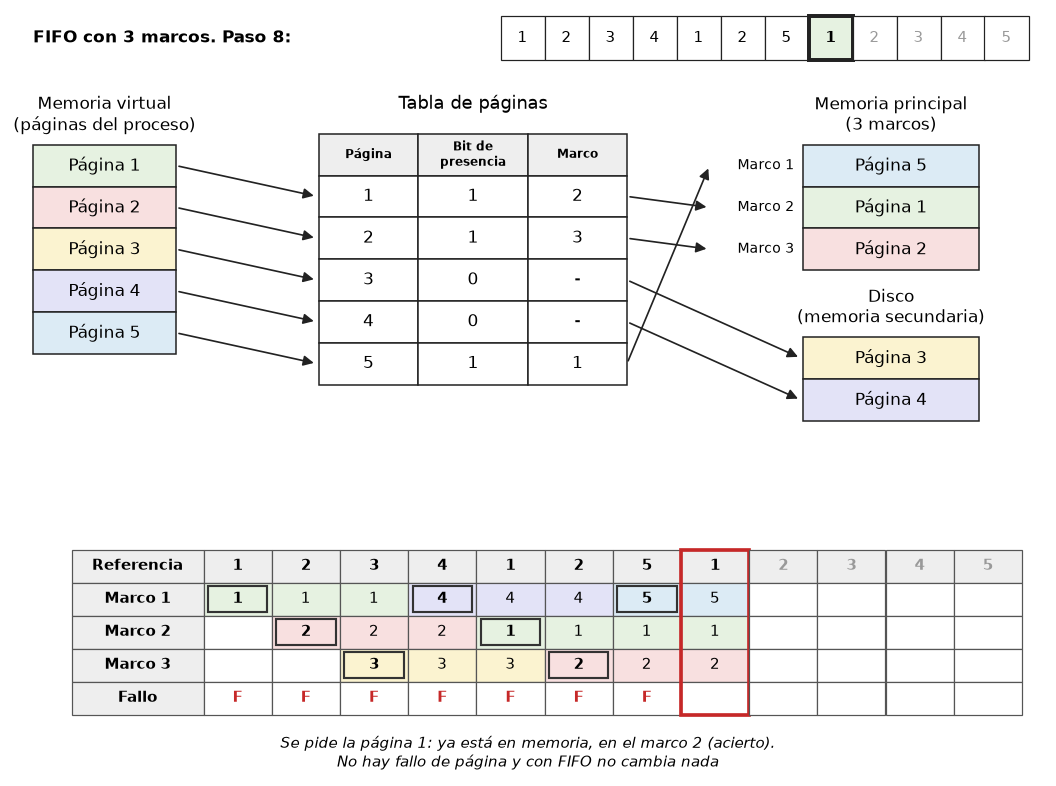
Paso 8: se pide la página 1: ya está en el marco 2 (acierto). Con FIFO no cambia nada.
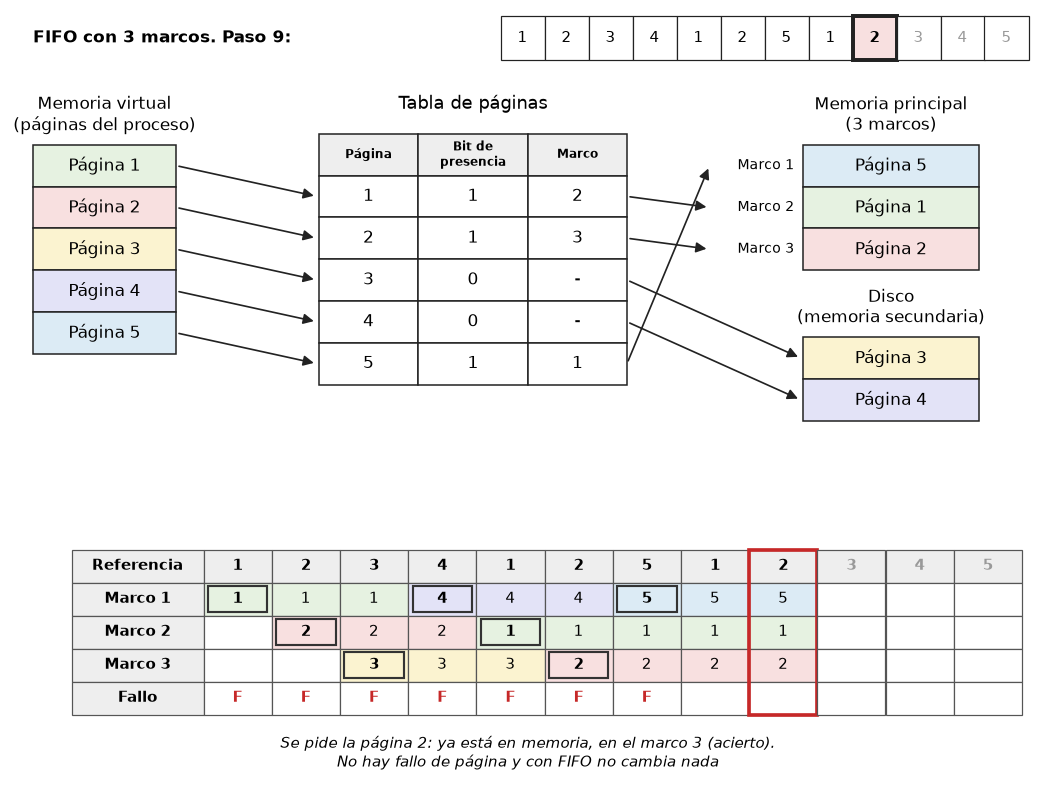
Paso 9: se pide la página 2: ya está en el marco 3 (acierto). Con FIFO no cambia nada.
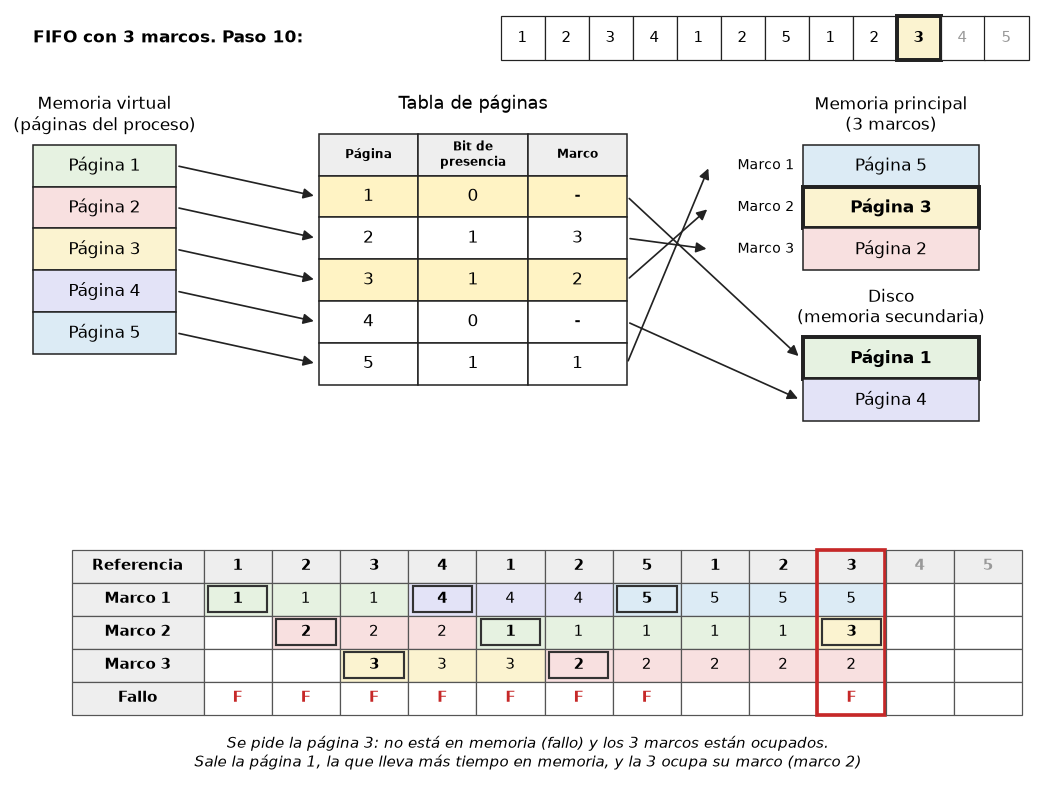
Paso 10: se pide la página 3: fallo. Sale la página 1, que es la que lleva más tiempo en memoria (entró en el paso 5), aunque se acabe de usar en el paso 8: a FIFO solo le importa cuándo entró. La 3 ocupa el marco 2.
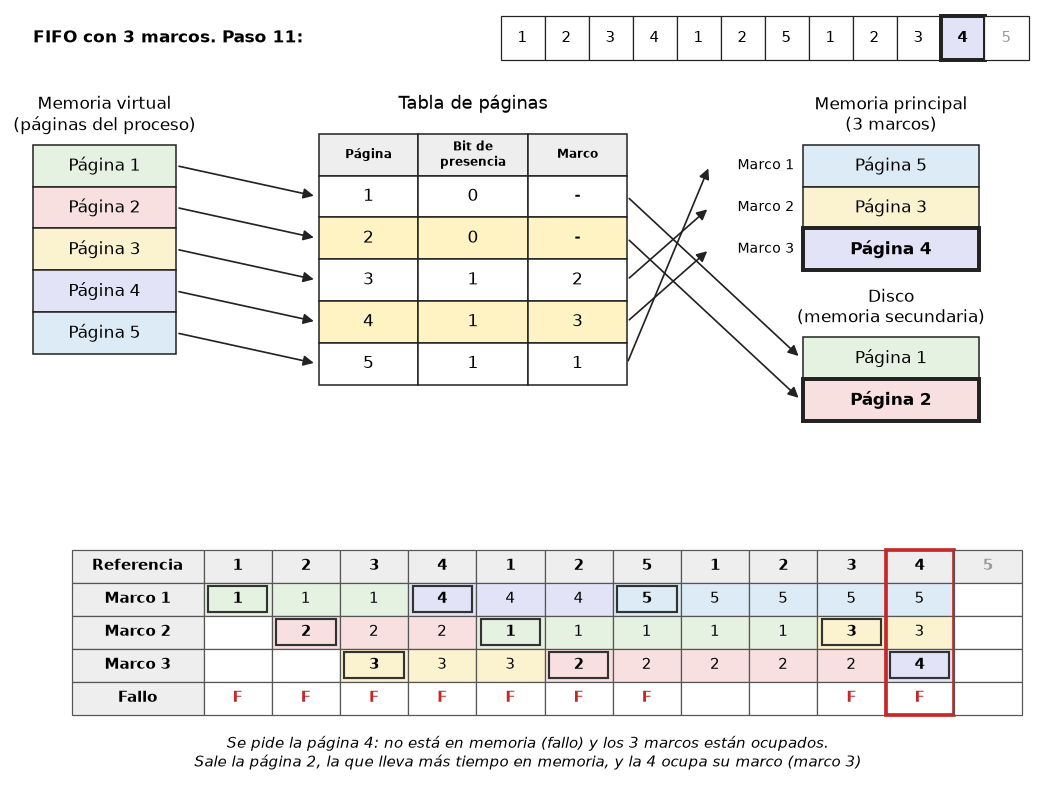
Paso 11: se pide la página 4: fallo. Sale la página 2 (entró en el paso 6) y la 4 ocupa el marco 3.
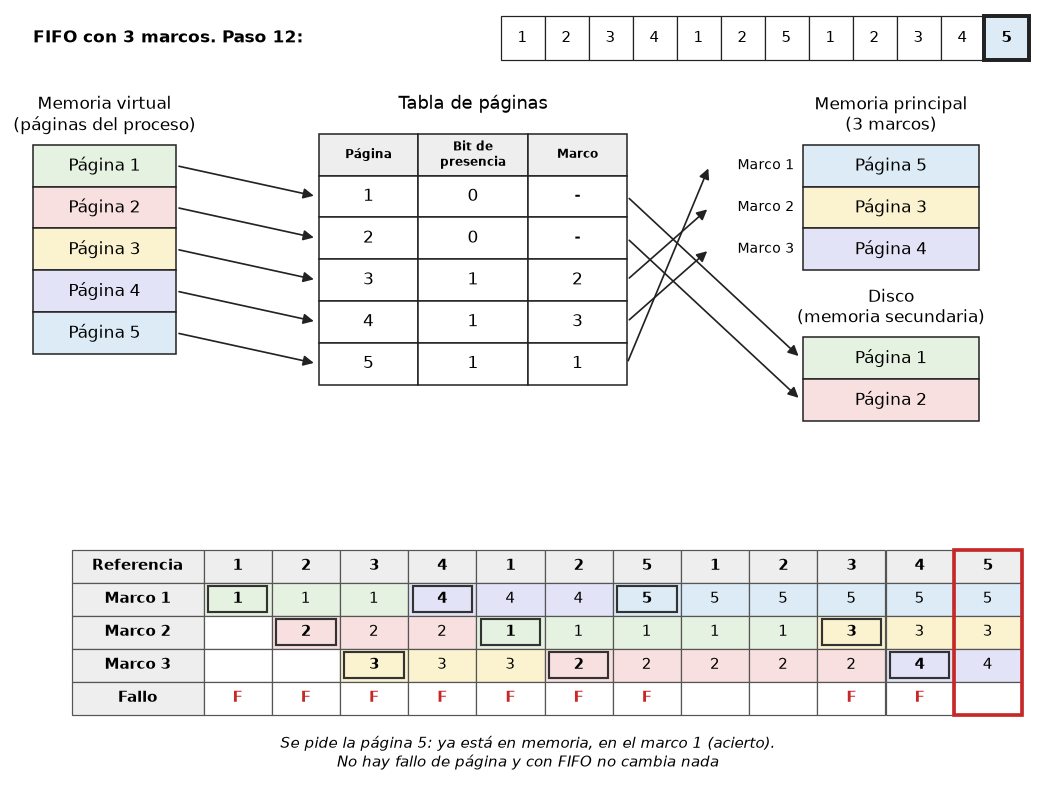
Paso 12: se pide la página 5: ya está en el marco 1 (acierto). En total, FIFO ha tenido 9 fallos.
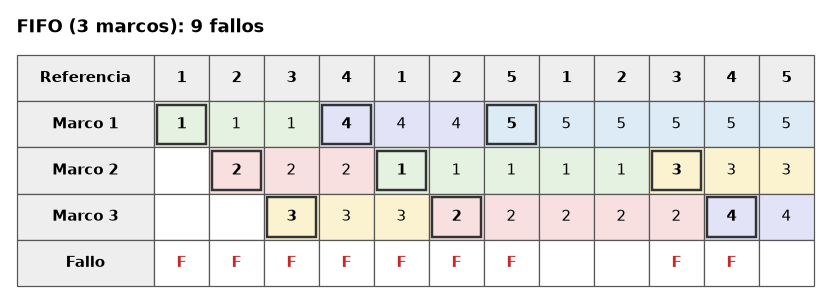
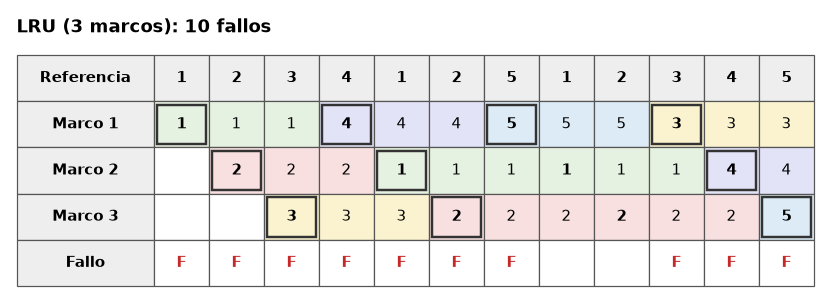
Veamos un ejemplo con la cadena de referencias 1,2,3,4,1,2,5,1,2,3,4,5 y 3 marcos, inicialmente vacíos. La primera fila es la página que pide el proceso, cada fila "Marco" muestra qué página hay en cada hueco de la memoria física, el recuadro grueso indica la página que acaba de entrar por un fallo y la F roja marca los fallos de página:
FIFO: 9 fallos
LRU: 10 fallos
En LRU un acierto también cuenta como uso: en negrita (sin recuadro, porque el marco no cambia) está la página que se usa en cada acierto. Por eso en la 10.ª referencia sale la 5: el 1 y el 2 se acaban de usar en la 8.ª y la 9.ª, y la 5 no se usa desde la 7.ª.
Óptimo: 7 fallos
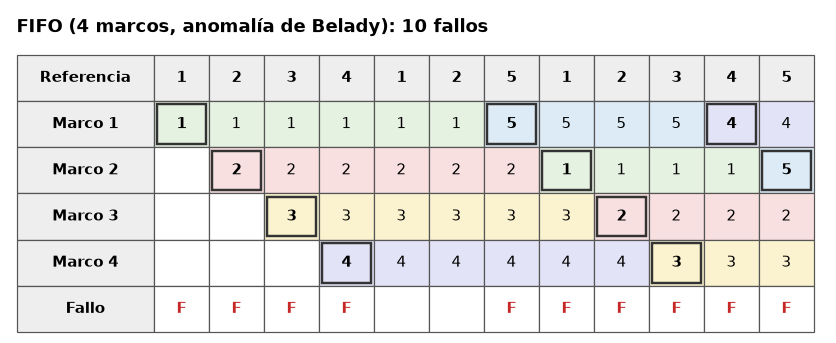
Lo normal es que con más marcos haya menos fallos, pero con FIFO no siempre ocurre. Si repetimos el ejemplo con 4 marcos, FIFO da 10 fallos, uno más que con 3. Este fenómeno se conoce como anomalía de Belady; LRU y Óptimo no la sufren.
Si los procesos tienen menos marcos de los que necesitan para su conjunto de páginas de uso habitual, se producen fallos de página continuamente y el sistema pasa más tiempo trayendo páginas del disco que ejecutando procesos. Esta situación se llama hiperpaginación (thrashing).
Planificación del disco#
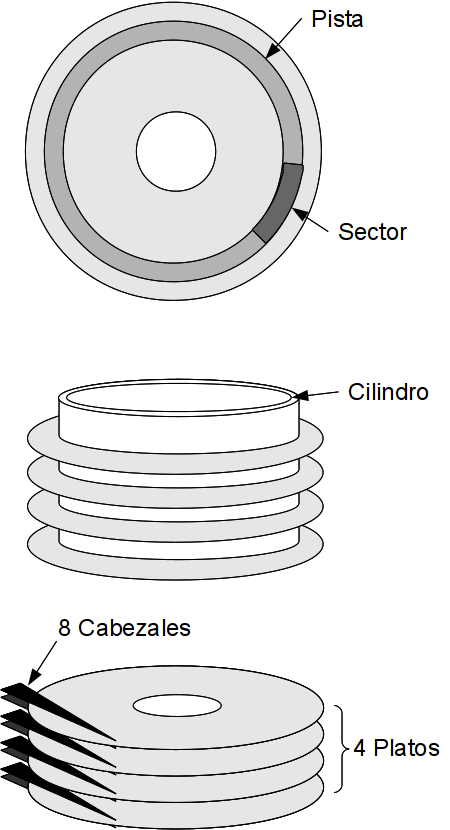
El tiempo de lectura/escritura de un sector del disco depende del tiempo de búsqueda (mover la cabeza hasta la pista), el retardo rotacional y el tiempo de transferencia. De todos ellos, el único que se puede optimizar desde el programa gestor del disco es el primero, ya que los otros dos dependen de las características propias del disco y del bus de transmisión.
Cuando un proceso requiere una operación de E/S del disco, envía la correspondiente llamada al SO (como todos los procesos) especificando la siguiente información:
Tipo de operación (si se trata de una entrada o de una salida)
Dirección en el disco: unidad, cilindro, superficie, bloque
Dirección en memoria
Cantidad de información que se va a transferir
Las peticiones que van llegando se ponen en una cola, y el SO tiene que elegir cuál de las pendientes atiende a continuación.
Veamos el siguiente ejemplo
En la cola se han almacenado, por orden de llegada, las siguientes peticiones de pistas: 20,130,180,105,145,32,50,2,150,120,4
La cabeza de lectura/escritura está inicialmente en la pista 80 y el disco tiene las pistas de 0 a 199. En SCAN y C-SCAN la cabeza empieza bajando.
En las gráficas, el eje horizontal es la pista en la que está la cabeza y el vertical el total de pistas recorridas hasta ese momento; el círculo blanco es la posición inicial.
FIFO (First in, first out)
Las solicitudes de acceso se almacenan en una cola, de manera que la primera petición que llega es la primera que se sirve. Total: 808 pistas.

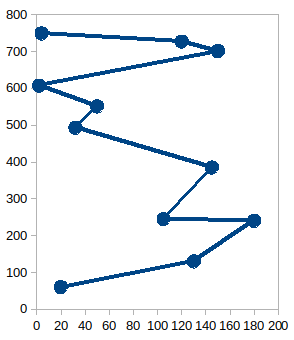
SSTF (Shortest Seek Time First) Primero la de menor tiempo de búsqueda, es decir, la más cercana.
Consiste en atender la petición que requiere el menor movimiento de la cabeza de lectura/escritura desde su posición actual. Como la cabeza se mueve en las dos direcciones, hay situaciones en las que puede haber empate; en dicho caso se atenderá cualquiera de las dos. Total: 278 pistas.
Su inconveniente es la inanición (starvation): si no dejan de llegar peticiones cerca de la cabeza, una petición lejana puede quedarse sin atender indefinidamente.

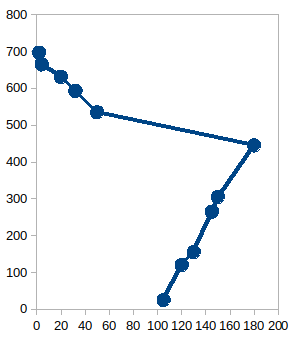
Planificación SCAN (rastreo) Evita la inanición de SSTF.
La estrategia es ir recorriendo todas las pistas en una dirección, atendiendo las peticiones que encuentra, hasta llegar al extremo del disco; allí cambia de sentido y atiende las peticiones en el sentido contrario. También se le conoce como el algoritmo del ascensor, por su analogía: llega hasta arriba, parando donde haga falta, y después baja atendiendo las nuevas paradas. Total: 260 pistas.

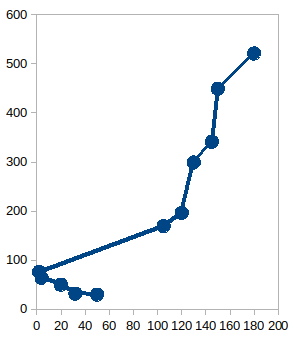
El problema de SCAN es que los tiempos de espera no son uniformes. Las pistas del centro se visitan a intervalos regulares (la cabeza pasa por ellas a la ida y a la vuelta), mientras que las de los extremos se visitan dos veces seguidas (al llegar y al volver) y después tienen que esperar a que la cabeza vaya hasta el otro extremo y regrese. Una petición que llega justo detrás de la cabeza cerca de un extremo es la que más espera.
Planificación C-SCAN Restringe el rastreo en un único sentido.
De esta forma evita el problema anterior de SCAN. Siguiendo con la analogía del ascensor, equivale a que el ascensor solo hiciera paradas al bajar: cuando llega abajo, sube hasta arriba del todo sin realizar paradas y desde allí vuelve a bajar realizando las nuevas paradas. Total: 373 pistas.
En estos apuntes el salto de vuelta (de la pista 0 a la 199) se cuenta en el total, porque la cabeza tiene que recorrer esas pistas. Algunos libros no lo cuentan, así que, si consultas otras fuentes, puede salirte un total distinto.

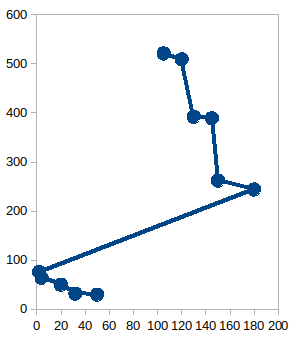
En la práctica se suelen usar las variantes LOOK y C-LOOK, que funcionan igual que SCAN y C-SCAN pero no llegan hasta el extremo del disco: cambian de sentido (o saltan) en cuanto no quedan peticiones en esa dirección. En el ejemplo, LOOK recorrería 256 pistas y C-LOOK 331.
Resumen del ejemplo (pistas recorridas por la cabeza):
FIFO |
SSTF |
SCAN |
C-SCAN |
LOOK |
C-LOOK |
|---|---|---|---|---|---|
808 |
278 |
260 |
373 |
256 |
331 |
SSTF y SCAN/LOOK son los que menos recorren. C-SCAN y C-LOOK recorren más por el salto de vuelta, pero a cambio reparten mejor los tiempos de espera entre todas las pistas.