Sistemas de codificación#
Codificación numérica#
Binario Puro#
Solo pueden representar nº positivos. Con n bits el rango es 0 ≤ x ≤ 2 n - 1 ; con n=8 [ 0 ≤ x ≤ 255 ]
23 10) = 00010111 BP,n=8)
Signo y magnitud#
El primer bit para representar el signo
Ejemplo : n=8
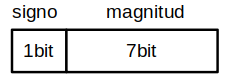
Rango -(2 n-1- 1) ≤ x ≤ (2 n-1-1) ; este caso con n=8 [ -127 ≤ x ≤ 127 ]
El problema del signo y magnitud es que tiene dos ceros, +0 = 00000000 y -0 = 10000000, y que para restar no basta con sumar los números, por eso se utilizan los complementos:
Complemento a uno (C1): para un nº negativo se escribe el número en positivo y se cambian todos los bits, 0 por 1 y 1 por 0. Sigue teniendo dos ceros y su rango con n=8 es el mismo que en signo y magnitud [ -127 ≤ x ≤ 127 ]
Complemento a dos (C2): es el C1 + 1. Tiene un solo cero, así que su rango es -(2 n-1) ≤ x ≤ (2 n-1-1) ; con n=8 [ -128 ≤ x ≤ 127 ]. Es el que utilizan los ordenadores, porque con él la resta se hace sumando: A - B = A + C2(B)
Los números positivos se escriben igual en signo y magnitud, C1 y C2, solo cambian los negativos. En todos ellos el primer bit indica el signo: 0 positivo y 1 negativo.
Ejemplo : -23 con n=8
Codificación en coma fija y en coma flotante#
La codificación en coma fija se utiliza para referirse a los números con una cantidad de cifras decimales constante. La representación de los números en coma flotante es una representación exponencial, de forma que la posición de la coma no es fija, lo que permite representar números muy grandes y muy pequeños con la misma cantidad de bits, algo muy interesante en trabajos de cálculo científico. El estándar más extendido en coma flotante es el estándar IEEE 754.
Estándar IEEE 754#
(Institute of Electrical and Electronics Engineers)
Precisión simple 32 bits: 1 bit de signo, 8 bits de exponente y 23 bits de mantisa
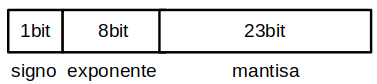
Ejemplo :
Pasamos a binario:
19,5625 10) = 10011,1001 2)
Colocamos la coma decimal a la derecha del bit más significativo
10011,1001 = 1,00111001*2 4
Escribir exponente en exceso a 2 n-1 – 1, con n=8 bits de exponente el exceso es 2 7 – 1 = 127
4+( 2 8-1 – 1) = 4 + 127 = 131 10) = 10000011 2)
La mantisa es lo que queda a la derecha de la coma: 00111001, completando con ceros hasta los 23 bits. El 1 de la izquierda de la coma no se guarda, porque siempre es 1 (bit implícito)
El bit de signo es 0 porque el número es positivo, si fuera negativo sería 1
Finalmente queda:
Codificación alfanumérica#
ASCII#
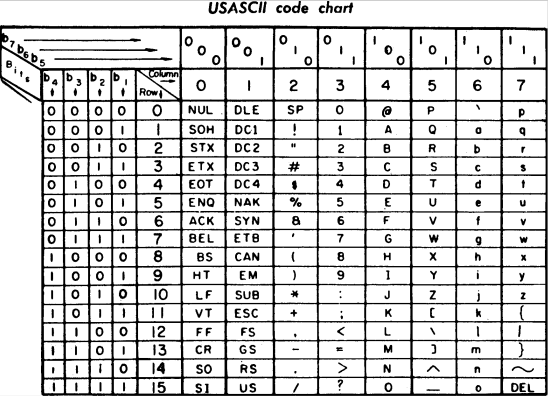
“American Standard Code for Information Interchange”, cada carácter se codificaba mediante 7 dígitos binarios (128 caracteres diferentes). Fue creado para el juego de caracteres ingleses más corriente. Del 32 (el espacio) al 126 se conocen como caracteres imprimibles, representan letras, signos de puntuación y varios símbolos; por ejemplo la letra A es el 65 10) = 01000001 2). Del 0 al 31 y el 127 son caracteres de control, que no se imprimen sino que dan órdenes, como el salto de línea (10) o el tabulador (9)
ASCII Extendido#
Debido a las limitaciones del ASCII se definen varios códigos de 8 bits (256 caracteres) para lenguas semejantes, que mantienen los 128 primeros del ASCII y usan los otros 128 para las letras de cada idioma, como la ñ o las vocales con tilde. Por ejemplo la página de códigos 437 del MS-DOS, la ISO-8859-1 (Latin-1) o la Windows-1252. Cada uno asigna los mismos números a caracteres distintos, así que no dan una solución final al problema: si un texto se escribe con una codificación y se lee con otra, aparecen caracteres extraños, como el típico "ñ" en lugar de "ñ".
UNICODE#
Como solución a estos problemas en 1991 se acordó utilizar el estándar Unicode, es una gran tabla, que asigna un código a cada uno de sus más de 150.000 símbolos, los cuales abarcan los alfabetos europeos, chinos, japoneses, coreanos, emojis, etc. El código se escribe en hexadecimal precedido de U+, por ejemplo la A es U+0041 y la ñ es U+00F1
UTF-8#
(8-bit unicode transformation format) es un formato de codificación de caracteres UNICODE, utilizando símbolos de longitud variable. UTF-8 divide los caracteres unicode en varios grupos, en función del n.º de bytes para codificarlos.
1 byte → ASCII → 0xxxxxxx “El primer bit es 0”
2 bytes → Latín con tildes y ñ, griego, cirílico, árabe, hebreo → 110xxxxx 10xxxxxx
3 bytes → Chino, Japonés, Coreano y la mayoría de símbolos → 1110xxxx 10xxxxxx 10xxxxxx
4 bytes → Emojis 😀, alfabetos antiguos → 11110xxx 10xxxxxx 10xxxxxx 10xxxxxx
Por ejemplo, la ñ es U+00F1 = 000 1111 0001 2), que ocupa 2 bytes: 11000011 10110001 = C3 B1 16)
Como los textos en ASCII son también UTF-8 válido, y un carácter en inglés ocupa un solo byte, UTF-8 es hoy la codificación de casi todas las páginas web y de GNU/Linux.
Estos son algunos ejemplos, entre otros como la codificación BCD, EBCDIC, Biquinaria, IEEE 754 de 64 bits, Fieldata, etc ....